Per anni ci hanno raccontato che l’intelligenza artificiale presto o tardi avrebbe rivoluzionato il mondo assicurativo. Ebbene, la rivoluzione è arrivata.
Solo che, come spesso accade quando si parla di assicurazioni, sarebbe opportuno chiedersi non soltanto quali vantaggi porterà (e a chi), ma anche cosa accadrà quando quella stessa tecnologia finirà per incidere concretamente sui diritti degli assicurati e dei danneggiati.
Perché l’intelligenza artificiale non viene più utilizzata soltanto per rispondere alle domande di un cliente o per automatizzare qualche attività amministrativa. Sta entrando progressivamente nella valutazione dei rischi, nella determinazione dei premi, nell’individuazione delle frodi e, soprattutto, nella gestione dei sinistri.
E i numeri iniziano ad essere importanti.
Secondo un’indagine pubblicata il 2 febbraio scorso dall’EIOPA, l’Autorità europea delle assicurazioni e delle pensioni aziendali e professionali, e condotta su 347 imprese assicurative di 25 Paesi europei, il 65% delle compagnie interpellate utilizza già sistemi di intelligenza artificiale generativa e un ulteriore 23% prevede di adottarli nei prossimi tre anni.
Gli ambiti nei quali questi sistemi vengono maggiormente impiegati, con l’obiettivo dichiarato di migliorare l’efficienza dei processi e ridurre i costi, comprendono proprio il servizio al cliente, la distribuzione dei prodotti assicurativi ma anche la gestione dei sinistri.
Una compagnia assicurativa è un’impresa e, come qualsiasi altra impresa, ha tutto il diritto di utilizzare le nuove tecnologie per rendere più efficiente la propria organizzazione.
Il problema nasce quando il risparmio ottenuto attraverso l’automazione incontra e si scontra con il diritto di una persona ad ottenere una prestazione assicurativa o il risarcimento di un danno.
Perché a quel punto una domanda diventa inevitabile: se l’intelligenza artificiale sbaglia, chi ne risponde?
Quando l’intelligenza artificiale sbaglia in assicurazione
Capiamo, prima di tutto, come potrebbe sbagliare.
Se siamo nel contesto dei servizi commerciali informativi al cliente, il classico “call center” automatizzato, i rischi sono tutto sommato marginali. Il cliente può ricevere un’informazione commerciale errata perché magari è stato profilato in modo impreciso, oppure il “bot” ha compreso in modo errato quale fosse la reale richiesta ricevuta. Magari perderà il cliente, perché gli è stata data un’informazione errata o incompleta su una polizza che intende sottoscrivere e che probabilmente troverà presso un’altra impresa.
Nulla di grave, insomma, se siamo nel contesto delle informazioni commerciali.
La questione diventa più delicata quando l’intelligenza artificiale è chiamata a gestire richieste provenienti da soggetti che sono già clienti della compagnia, riguardanti prodotti assicurativi già sottoscritti.
Se l’assistente virtuale comunica al cliente che una garanzia, nel caso concreto segnalato, è attiva quando invece non lo è, che succede?
Succede che il cliente è convinto di essere coperto, ma poi, quando denuncia il sinistro e pretende l’indennizzo o il risarcimento, un umanissimo liquidatore, contratto alla mano, gli comunica che quella garanzia in realtà non opera.
A quel punto la questione si complica.
Certo, il contenuto del contratto rimane il punto di partenza. Ma fino a che punto una compagnia può disconoscere l’informazione fornita al proprio cliente da un assistente virtuale che essa stessa ha scelto di mettere a sua disposizione?
E soprattutto: su chi ricadono le conseguenze dell’affidamento che quell’informazione ha generato?
Intelligenza artificiale e gestione dei sinistri
La questione diventa poi ancora più delicata nella gestione dei sinistri.
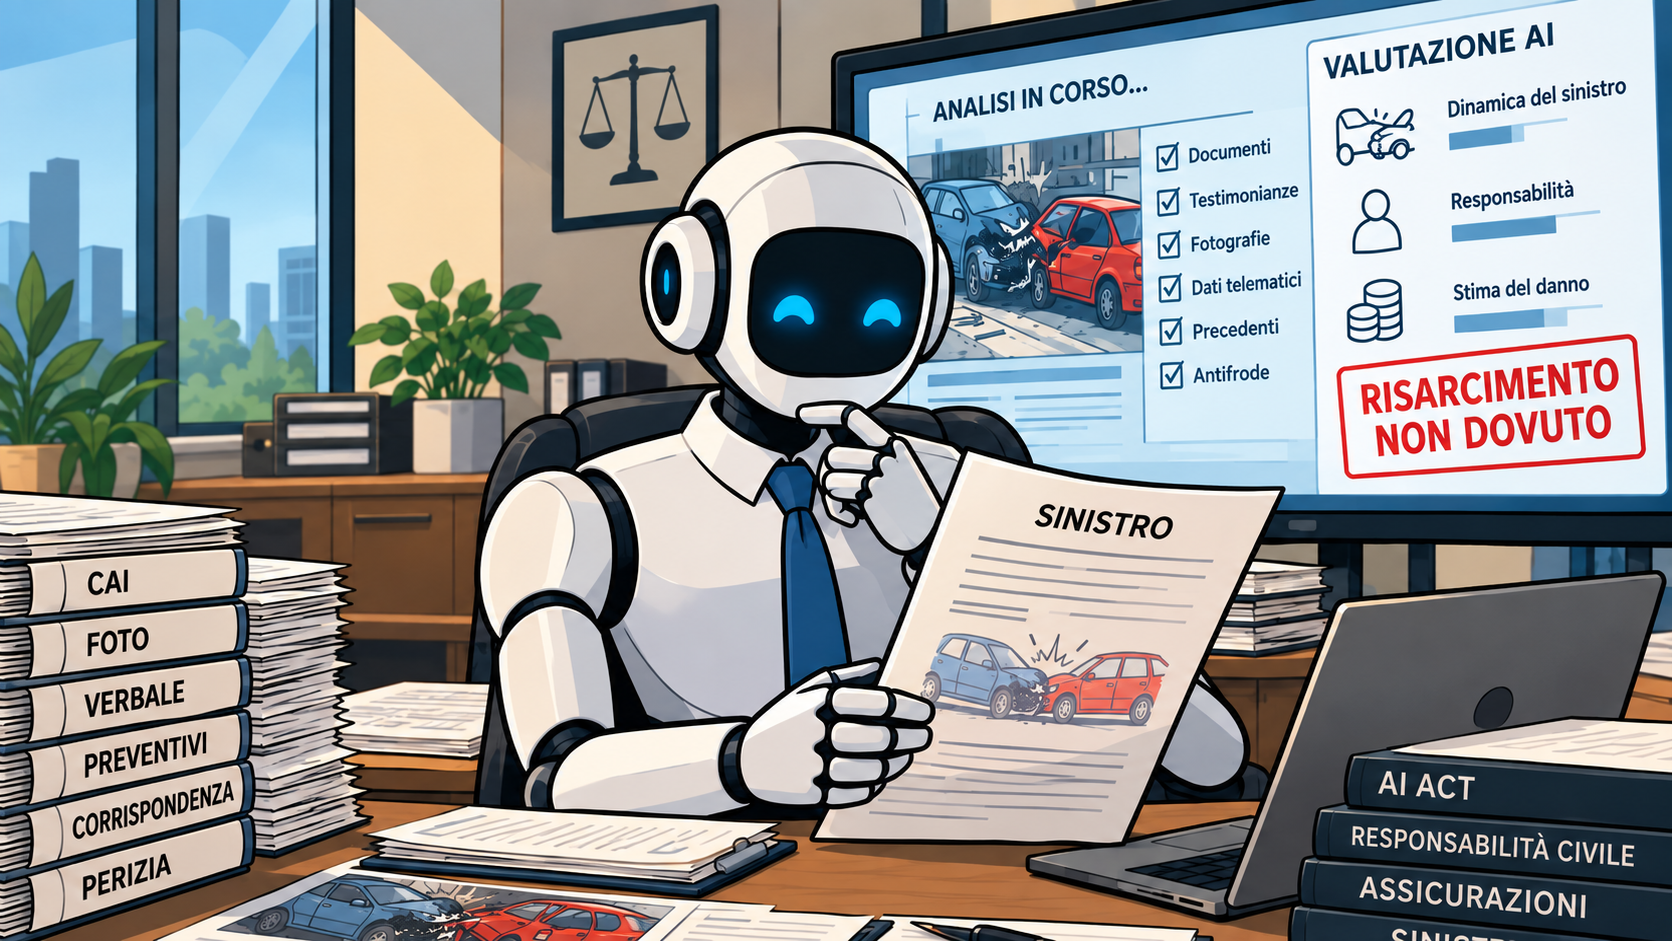
Immaginiamo — perché è di questo che parliamo, anche se sembra fantascienza — un sistema capace di analizzare automaticamente una richiesta risarcitoria, confrontarla con migliaia di casi precedenti, valutare documenti medici, fotografie, preventivi, dinamiche del sinistro e indicatori antifrode e infine suggerire al liquidatore se pagare, quanto pagare oppure se respingere la richiesta.
Dal punto di vista aziendale è qualcosa di incredibile, addirittura affascinante.
Ma i rischi di una decisione errata, basata su una valutazione incompleta o imprecisa, quali sono?
Oggi una pratica riguardante un sinistro in RC auto può contenere il modulo di constatazione amichevole, fotografie dei veicoli, dichiarazioni dei conducenti e dei testimoni, verbali delle autorità, preventivi di riparazione, dati telematici e, nei casi più complessi, documentazione medica e perizie tecniche.
Tutti documenti che possono essere “dati in pasto” ad un sistema di intelligenza artificiale, in grado di leggerli e classificarli, estrarne le informazioni rilevanti, confrontarle tra loro, individuare eventuali anomalie e magari formulare una valutazione sulla dinamica del sinistro e sulle responsabilità dei soggetti coinvolti.
Fantastico. Almeno finché non sbaglia. Perché il rapporto tra intelligenza artificiale e sinistri assicurativi è tutt’altro che semplice da gestire.
Se il sistema interpreta male un documento, non coglie un particolare presente in una fotografia oppure attribuisce un significato errato a un dato, può condizionare tutto ciò che viene dopo.
Un punto d’urto può essere interpretato in maniera sbagliata; una dichiarazione può essere letta fuori dal suo contesto; una frenata rilevata dalla telematica può essere considerata indice di una determinata condotta quando, in realtà, era proprio la manovra con la quale il conducente tentava di evitare l’incidente.
Il problema è che l’intelligenza artificiale è straordinariamente efficace nell’individuare correlazioni e ricorrenze all’interno di enormi quantità di dati.
Ma la responsabilità civile non è statistica.
Due incidenti apparentemente identici possono avere responsabilità completamente diverse per un particolare che, agli occhi di un algoritmo, potrebbe apparire marginale: una precedenza, una segnalazione luminosa, una posizione sulla carreggiata, una manovra di emergenza oppure semplicemente una testimonianza che modifica completamente la ricostruzione dei fatti.
Quando l’algoritmo impara dalle vecchie liquidazioni
C’è poi un problema ancora più sottile.
Immaginiamo un algoritmo addestrato utilizzando migliaia di sinistri precedentemente gestiti dalla stessa compagnia. Il sistema potrebbe imparare con grande precisione come sono state definite in passato determinate pratiche.
Ma questo non significa necessariamente che abbia imparato quale fosse, giuridicamente, la corretta attribuzione delle responsabilità.
Potrebbe aver imparato, molto più banalmente, come quella compagnia era abituata a liquidare quei sinistri e come i liquidatori abbiano applicato in passato linee guida e direttive aziendali che non necessariamente sono corrette sotto il profilo giuridico.
E la differenza non è proprio irrilevante, specie quando consideriamo che la definizione stragiudiziale di un sinistro è, per l’appunto, il risultato di un accordo tra le parti, non di un’operazione algebrica.
Il rischio è quello di trasformare prassi liquidative passate in una sorta di regola matematica per decidere i casi futuri.
In altre parole, l’algoritmo della compagnia potrebbe essere perfettamente coerente con i dati sui quali è stato addestrato ed essere, allo stesso tempo, perfettamente sbagliato nel caso concreto.
AI e antifrode assicurativa: il rischio dei falsi positivi
Analogo problema si pone nell’attività antifrode, che rappresenta uno degli ambiti nei quali le compagnie stanno mostrando maggiore interesse per l’impiego dell’intelligenza artificiale.
Il confronto tra migliaia di sinistri finalizzato a individuare ricorrenze sospette o altre anomalie non potrà mai essere esente dai “falsi positivi”.
In questo processo automatico un errore dell’algoritmo potrebbe determinare, senza un reale motivo, l’inserimento di una pratica in un percorso antifrode, provocare ulteriori accertamenti, rallentare la liquidazione oppure condizionare il successivo giudizio umano sulla richiesta risarcitoria.
Con il rischio, peraltro facilmente comprensibile da chiunque abbia utilizzato almeno una volta questi strumenti, di attribuire alla risposta della macchina più credibilità che alle proprie intuizioni e valutazioni.
Nell’indagine europea sull’utilizzo dell’intelligenza artificiale generativa nel settore assicurativo pubblicata nel 2026 dall’EIOPA sono state le stesse imprese assicuratrici a indicare le cosiddette “allucinazioni”, cioè la produzione di informazioni apparentemente plausibili ma inesatte, come il principale rischio connesso a questi sistemi.
Restiamo nel caso del rapporto tra intelligenza artificiale e sinistri assicurativi, in particolare nella fase di valutazione di un sinistro stradale che ha determinato danni fisici al malcapitato.
Supponiamo che l’algoritmo riassuma una relazione medica attribuendo al danneggiato una patologia che in realtà il medico aveva escluso.
Oppure che non colga il fatto che una determinata menomazione era assente prima dell’incidente perché magari la relazione non è sufficientemente chiara sul punto.
O ancora che legga una perizia, interpreti erroneamente un dato e proponga una quantificazione del danno inferiore.
Il liquidatore riceve un fascicolo già riassunto, classificato e valutato dal sistema e prende la propria decisione sulla base di quelle informazioni perché non dubita del sistema che l’ha generata in modo così preciso, completo, stilisticamente perfetto e matematicamente ineccepibile.
È proprio qui che nasce il problema della responsabilità: formalmente la decisione l’ha assunta il liquidatore, per conto della compagnia. Tecnicamente, però, è stata determinata da una macchina, che ha fatto risparmiare molto tempo e lavoro al liquidatore e, di riflesso, molto denaro alla compagnia.
Determinando, però, un errore.
AI Act e assicurazioni: quali sistemi sono ad alto rischio?
Proprio parlando di correttezza del funzionamento dei sistemi di intelligenza artificiale, vale la pena richiamare l’AI Act, il regolamento con il quale l’Unione europea ha introdotto un insieme di regole destinate a disciplinarne l’utilizzo, prevedendo obblighi diversi a seconda del livello di rischio che questi sistemi possono comportare per le persone.
Ed è qui che emerge una prima curiosa contraddizione della normativa europea.
L’AI Act considera espressamente ad alto rischio i sistemi utilizzati per la valutazione del rischio e la determinazione del prezzo delle polizze vita e salute. Non attribuisce invece automaticamente la stessa qualificazione ai sistemi utilizzati per la gestione dei sinistri.
Il servizio ufficiale della Commissione europea dedicato all’AI Act indica addirittura, tra gli esempi esclusi dalla specifica fattispecie ad alto rischio prevista per le assicurazioni, proprio il claims management relativo alle polizze sanitarie.
Tradotto in termini molto semplici: l’algoritmo che contribuisce a stabilire quanto devo pagare per assicurarmi sulla salute può rientrare tra quelli ad alto rischio e quindi necessita di regole più stringenti, maggiori controlli e supervisione “umana”; quello che interviene nella gestione del sinistro, invece, non rientra automaticamente in questa categoria.
Su questo aspetto qualche riflessione sarebbe veramente opportuna.
Danni provocati dall’intelligenza artificiale: cosa prevede il decreto italiano
Sul diverso piano della responsabilità civile, fortunatamente, il legislatore italiano ha introdotto una piccola rivoluzione, forse passata troppo sotto silenzio.
Il 15 settembre 2026 è stato pubblicato in Gazzetta Ufficiale il Decreto legislativo 9 settembre 2026 n. 160, entrato in vigore il 30 settembre, contenente, tra le altre cose, specifiche disposizioni per il risarcimento dei danni cagionati a terzi dall’utilizzo di sistemi di intelligenza artificiale.
Il Decreto specifica che chi afferma di avere subito un danno derivante dall’utilizzo di un sistema di intelligenza artificiale può chiedere al giudice di ordinare alla controparte, o anche a un terzo che ne sia in possesso, l’esibizione degli elementi di prova pertinenti al funzionamento del sistema.
Non stiamo parlando di informazioni generiche, in quanto la norma richiama espressamente registri, documentazione relativa alla gestione dei rischi, documentazione tecnica e informazioni sui parametri e sulle modalità della supervisione umana.
In altre parole, di fronte ad una decisione algoritmica contestata il danneggiato non dovrebbe essere costretto a combattere contro un muro di gomma.
Nella responsabilità civile tradizionale il danneggiato deve normalmente dimostrare il fatto, il danno e il collegamento causale. Ma come potrebbe farlo quando gli elementi necessari per comprendere la decisione sono interamente nelle mani della controparte?
Quando poi il danno deriva dalla violazione di uno o più obblighi previsti dall’AI Act, il nesso di causalità tra quella violazione e il danno viene presunto, salvo prova contraria.
Fermo restando che la conformità del sistema di intelligenza artificiale agli obblighi previsti dall’AI Act, anche quando formalmente certificata, non esclude di per sé la responsabilità civile, dimostrabile con le regole ordinarie.
Fortunatamente il nostro legislatore si è accorto del problema dell’enorme asimmetria informativa tra chi utilizza l’AI e chi ne subisce le conseguenze, intervenendo apertamente a tutela del danneggiato — come accade purtroppo raramente — e riequilibrando almeno sul piano probatorio una situazione che, diversamente, sarebbe stata palesemente sbilanciata.
Azione diretta contro l’assicuratore per i danni da AI
La vera sorpresa, però, si trova nell’articolo 20 del decreto, che introduce l’azione diretta del danneggiato nei confronti dell’impresa che assicura la responsabilità civile del soggetto al quale viene imputato il danno provocato dall’utilizzo dell’intelligenza artificiale.
Un sistema, quello dell’azione diretta, che offre al danneggiato una tutela ulteriore: questi potrà infatti chiedere il risarcimento direttamente all’impresa assicurativa che presta la copertura di responsabilità civile al presunto responsabile, senza dover prima ottenere una condanna di quest’ultimo e poi attendere che sia lui a coinvolgere il proprio assicuratore.
Il meccanismo ricorda quello già conosciuto, ad esempio, nella RC auto e nella responsabilità sanitaria, anche se con alcune importanti differenze.
Il presunto responsabile dovrà comunque partecipare al giudizio, in qualità di litisconsorte necessario, e l’assicuratore potrà opporre al danneggiato le eccezioni derivanti dal contratto di assicurazione purché anteriori al sinistro.
Naturalmente, sempre che una copertura assicurativa esista: il decreto introduce infatti l’azione diretta, ma non un obbligo generalizzato di assicurazione per chi utilizza sistemi di AI.
Resta però il dato di fondo: per i danni derivanti dall’utilizzo dell’intelligenza artificiale il legislatore ha scelto di mettere direttamente il danneggiato di fronte a chi, almeno entro i limiti del massimale e delle condizioni di polizza, dovrà materialmente mettere mano al portafoglio.
Se decide l’algoritmo, qualcuno deve poterne verificare la decisione
L’intelligenza artificiale rappresenta certamente una straordinaria opportunità.
Può rendere più rapida la gestione dei sinistri, individuare frodi, analizzare grandi quantità di documenti, ridurre costi e probabilmente eliminare molte attività ripetitive che oggi rallentano inutilmente le pratiche.
Sarebbe assurdo opporsi a tutto questo, ma esiste una linea che non dovrebbe mai essere superata.
Più una decisione viene affidata a un algoritmo, più devono essere conservati e resi verificabili gli elementi che consentono di ricostruire come quella decisione sia stata assunta: quali dati siano stati utilizzati, quali istruzioni siano state impartite al sistema, quale risultato abbia prodotto, quale intervento umano vi sia stato e chi abbia infine assunto la decisione.
Di fronte ad una richiesta di risarcimento la frase “lo ha stabilito il sistema” non può diventare la versione tecnologicamente aggiornata del vecchio “la direzione non autorizza”.
L’intelligenza artificiale può aiutare l’uomo a decidere. Può suggerire, calcolare, confrontare e prevedere.
Ma nel momento in cui quella decisione produce un danno ad una persona, deve essere sempre possibile ricostruire chi l’ha adottata, perché l’ha adottata e chi è chiamato a risponderne.
Anche perché l’algoritmo, quando sbaglia, non dispone di un patrimonio per risarcire i danni che ha provocato.
Chi lo usa a proprio vantaggio, invece, sì.


